搜狗浏览器 官网下载
预加载提前备好,
点开常用页面几乎不用等。
搜狗浏览器 13 的实现可以逐层看:Chromium 内核加预加载负责速度,竖版工作台负责标签的排布,P2SP 多线程负责传输,视频小窗负责播放层的独立呈现,隐私与安全选项负责本机与网络两侧的取舍。
机制以当前版本实现为准 · 电脑版与手机端分别说明
机制带来的限制,容易被忽略
双核的机制能覆盖所有旧站点吗?
覆盖不了全部。双核只解决解析层面的差异,站点还可能在证书或业务流程上另设条件,异常时先判断属于哪一层。网银与内部系统不在承诺范围内。
多线程下载为什么还是会断?
分段传输要求服务端支持相应方式。能否续传取决于任务状态与服务端;文件取回后仍要核对来源。
配置有限时,标签数量本身会影响响应吗?
会。每个标签对应一份页面状态,脚本、视频与图片还会额外占用资源。工作台与标签恢复解决摆放和找回,降不了页面消耗。
截图与翻译在机制上分别做了什么?
截图取的是渲染结果,翻译先抽文本再交引擎。前者受动态加载影响,后者受原文与引擎影响,结果都要对照原材料。
无痕在机制上屏蔽了哪些、没屏蔽哪些?
它处理的是本机侧留存。请求照样发到服务器,网站与已登录账号仍知道这次访问。
安装前的机制性检查有哪些?
确认设备系统与安装要求,装前备份书签,启动后检查权限、主页与下载目录。
从机制上怎样确认一个下载页是否官方?
“官方下载官网”只是常见检索词,本站是第三方介绍站。可靠依据在权利人公开页面的域名、HTTPS 状态与文件签名。
安全提示在机制上对应什么?
网址安全检测对应请求与证书检查,下载风险提示对应文件来源核对。这些是清单,替代不了权利人的承诺。
打开入口前有哪些机制层面的确认动作?
核对网址拼写与证书状态,确认文件名与保存位置,装前用安全软件扫描并保留可恢复的备份。三个动作分别对应域名、文件与本机数据。
从界面看机制:三处实现的直观呈现
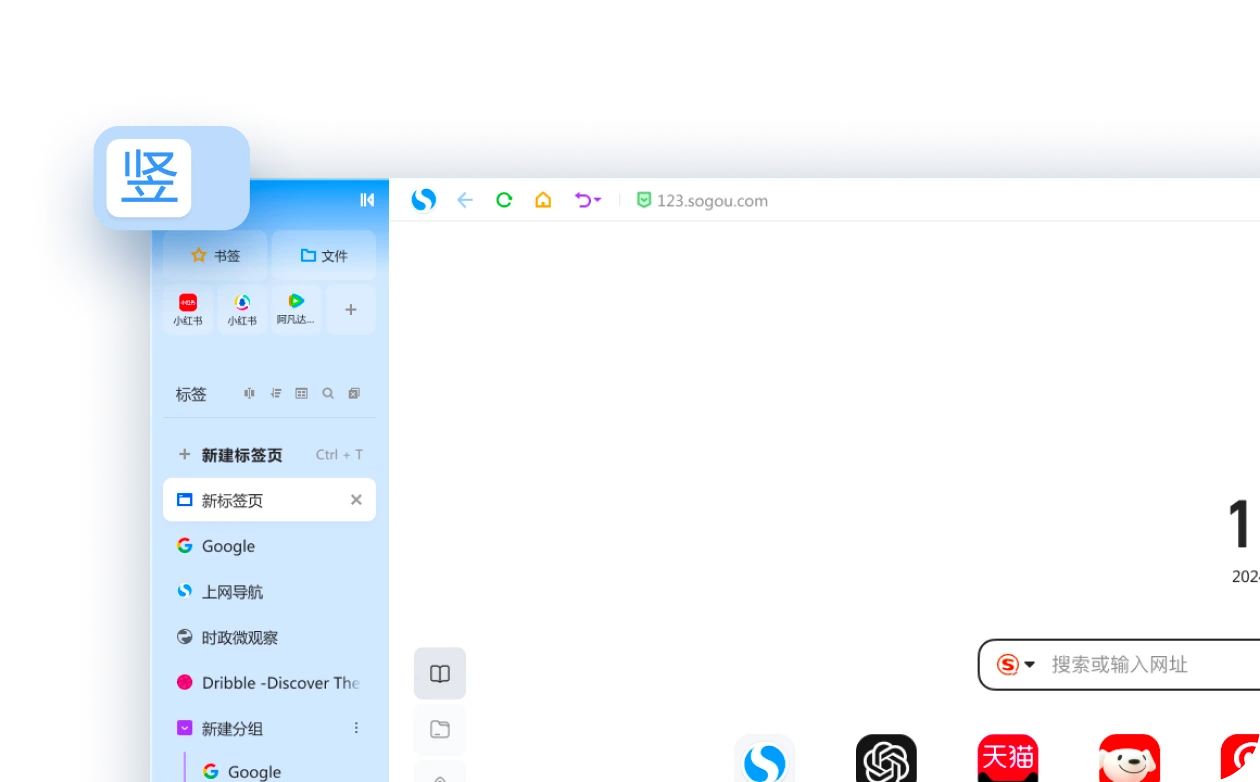
标签的组织方式,决定你多快能找到页面
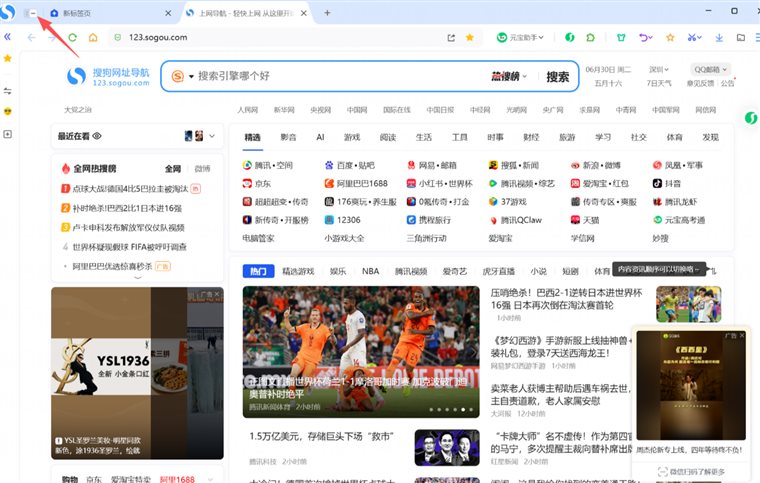
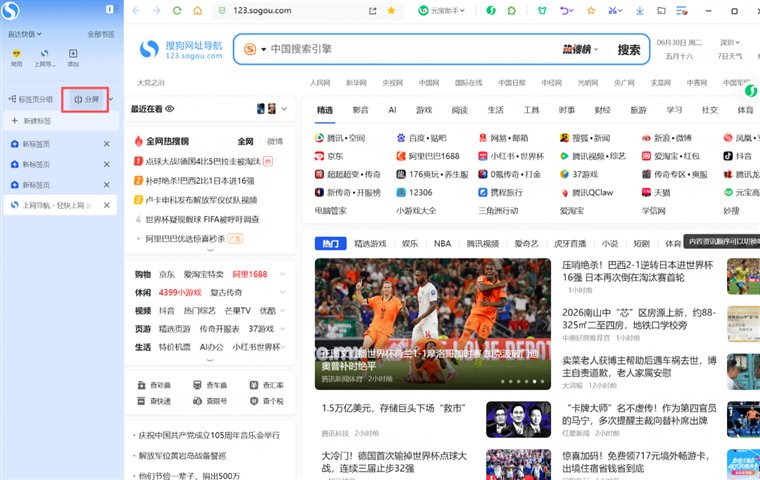
工作台改的是标签的排列规则,分组给标签加上分类,分屏把窗口拆成两块——三件事解决的是同一个问题的不同层面。
- 01先判断自己一天要开多少页面,再决定用哪种排列方式
- 02分组负责归类,工作台负责排列,两者一起用最省事
- 03分屏是临时并排,处理完记得把窗口合回去
几项核心机制,分别解决什么问题
下面几组能力各有各的机制,也各有各的边界,按作用分开说明。
内核机制:网页为什么能打开
能做什么:双核提供两套解析路径,应对网页技术栈的差异。
需要留意:解析能力解决的是渲染层问题,站点的证书、控件和业务规则不在这一层,打不开时仍要按对方要求核对环境。
过滤机制:拦下什么、留下什么
能做什么:过滤规则在请求发出前按条件拦截,隐私选项决定哪些标识与数据被留在本机。
需要留意:规则是取舍而不是越多越好,无痕只清理本机侧记录,服务器侧仍然照常接收请求。
下载机制:文件怎么被取回
能做什么:下载器把一个文件拆成多段并行传输,任务列表记录进度与保存位置。
需要留意:分段依赖服务端支持,速度由链路决定,文件是否完整还要看校验与来源是否可靠。
组织机制:标签与窗口怎么排
能做什么:工作台重排标签、分组给标签打标记、分屏拆开窗口,机制上都是对界面层的管理。
需要留意:这些都不触碰网页内部状态,标签恢复和资源占用仍受版本、页面与设备影响。
呈现机制:画面与文字怎么处理
能做什么:小窗把播放画面独立成一层,截图按区域或整页取图像,翻译先取文本再转换。
需要留意:动态页面取到的画面可能不完整,译文质量取决于原文与引擎,保留下来之后仍要核对。
存储机制:外观与资料存在哪
能做什么:皮肤切换外观资源,书签记录网址入口,这些都属于本地数据。
需要留意:迁移与同步有各自入口和条件,不能从一个选项推断另一个的数据已经同步过去。
放到真实场景里,这些机制怎么表现
以下是按机制推导的使用思路,不是对所有站点和设备的兼容承诺。
项目并行时的组织方式
标签数量变多时,先用工作台把排列方式调成适合当前屏幕的形态,再用分组标记项目;关前确认有无未保存状态。
遇到解析不了的环境
页面异常时,先分清属于渲染层还是站点额外要求:证书、控件与账号权限都可能是原因,换内核不解决站点侧规则。
取回大文件的过程
大文件下载需确认三件事:来源是否可靠、磁盘是否够用、保存路径是否合适;能否续传取决于任务与服务器。
离开与回来的衔接
回来接着办事依赖书签与站点侧保存,而非浏览器自动恢复;前者是明确入口,后者是便利功能。
本地数据的迁移边界
本地数据能否带走取决于各类数据的迁移机制:书签一般可复制,账号与同步状态需看对应服务。
边看边处理的组合
并排对照用分屏,取画面用截图,读外文用翻译,继续播放用小窗;几种机制互不干扰。